Domain s1y.de kaufen?
Wir ziehen mit dem Projekt
s1y.de um.
Sind Sie am Kauf der Domain
s1y.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain s1y.de kaufen?
Wie nutzt man Windows Speech Recognition richtig in Visual Basic?
Um Windows Speech Recognition in Visual Basic zu nutzen, müssen Sie zunächst sicherstellen, dass Sie die entsprechenden Verweise auf die Speech API in Ihrem Projekt hinzugefügt haben. Dann können Sie die SpeechRecognitionEngine-Klasse verwenden, um Spracheingaben zu erkennen und zu verarbeiten. Sie können Ereignisse wie SpeechRecognized und SpeechRecognitionRejected abonnieren, um auf erkannte oder abgelehnte Spracheingaben zu reagieren. Schließlich können Sie die RecognizeAsync-Methode aufrufen, um die Spracherkennung zu starten und auf Benutzereingaben zu warten. **
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **

Ähnliche Suchbegriffe für Speech Recognition SR
Top-Angebote
Produkte zum Begriff Speech Recognition SR:
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer589,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
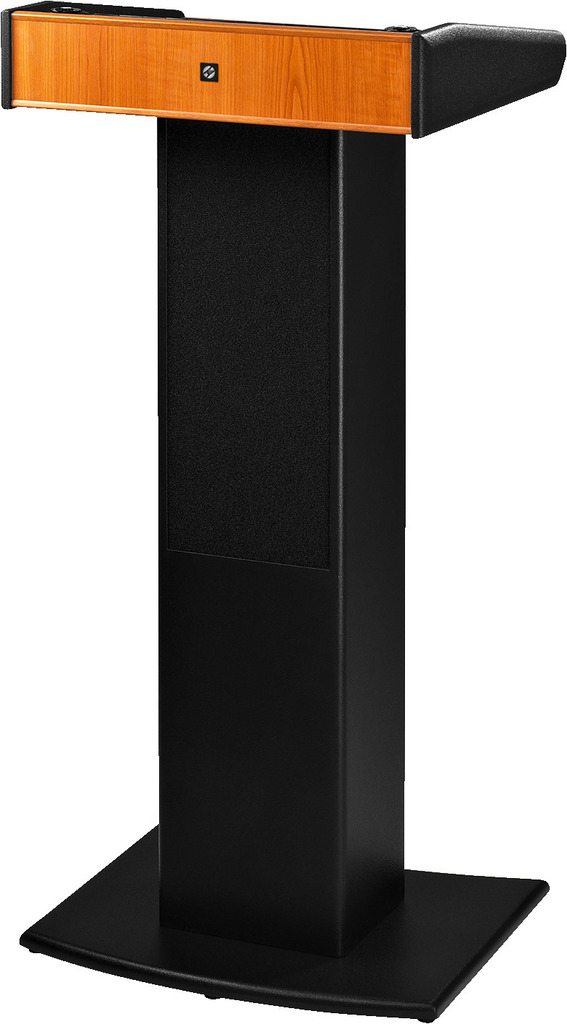
MONACOR SPEECH-104DSPEECH-104D, Eine innovative Qualit�tsl�sung f�r die hochwertige Sprach- und Musikbeschallung: Das SPEECH-104D-Aktiv-Rednerpult von MONACOR verbindet Klangqualit�t, Lautst�rkef�higkeit und Komfort in einer perfekten Weise. Akkubetrieben und damit komplett ortsunabh�ngig macht allein das SPEECH-104D aus jeder zu beschallenden Fl�che ein Auditorium. Es passt sich aber selbstverst�ndlich auch in jede gegebene Umgebung ein, wo eine zeitlich begrenzte oder auch permanente Redestelle ben�tigt wird. Die integrierte Verst�rker- und Lautsprechertechnik erlaubt dabei nicht nur die Sprachwiedergabe, sondern macht auch Musik und zum Beispiel Film- und Pr�sentationsvertonungen denkbar gut und einfach. Ein Schwanenhalsmikrofon einstecken und/oder eine Signalquelle anschlie�en - einschalten - fertig.1648,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Thon Truhencase t.bone Speech 100M Phenol braunThon Truhencase t.bone Speech 100M; Case mit herausnehmbarem 2HE Rack für die Steuereinheit; herausnehmbare Wanne mit 2 Schaumstoffinlays für die Sprechstellen (9 Deligierte oder Präsident) und Mikrofone; Platz für Kabel und Zubehör; Material: 6,5 mm Multiplex; 30 x 30 mm Alukante; 2 Butterflyverschlüsse mittel; 2 Feststellscharniere groß; 4 Klappgriffe mittel; 4 Kugelecken medium; 4 Kugelecken mit L-Ecke medium; 4 Lenkrollen (2 gebremst), Schaumstoffpolsterung; Farbe: Phenol braun; Außenmaße BxTxH: 705 x 595 x 605 mm; Gewicht: 28,7 kg; hergestellt in Deutschland799,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie kann Voice Recognition die Effizienz von Arbeitsabläufen verbessern?
Voice Recognition kann die Effizienz von Arbeitsabläufen verbessern, indem es die Eingabe von Texten beschleunigt und die Notwendigkeit von manueller Dateneingabe reduziert. Durch die Verwendung von Spracherkennung können Mitarbeiter Aufgaben schneller erledigen und sich auf andere wichtige Aufgaben konzentrieren. Dies führt zu einer Steigerung der Produktivität und Effizienz im Arbeitsalltag. **
-
Was kann man tun, wenn das Google Speech Service Update hängt?
Wenn das Google Speech Service Update hängt, gibt es einige Schritte, die du ausprobieren kannst. Zuerst solltest du sicherstellen, dass du über eine stabile Internetverbindung verfügst. Dann kannst du versuchen, das Update manuell neu zu starten oder das Gerät neu zu starten. Wenn das Problem weiterhin besteht, kannst du dich an den Google-Support wenden, um weitere Hilfe zu erhalten. **
-
Was bedeutet Hate Speech?
Hate Speech bezeichnet beleidigende, diskriminierende oder gewalttätige Äußerungen, die aufgrund von Rasse, Religion, Geschlecht, sexueller Orientierung oder anderen persönlichen Merkmalen Hass und Feindseligkeit fördern. Es handelt sich um eine Form der verbalen Gewalt, die Menschen verletzen und ihre Rechte verletzen kann. Hate Speech ist in vielen Ländern gesetzlich verboten und wird von Online-Plattformen und sozialen Medien zunehmend bekämpft. **
-
Was ist Hate Speech?
Hate Speech bezieht sich auf Äußerungen, die Hass, Diskriminierung oder Gewalt gegen bestimmte Personen oder Gruppen aufgrund ihrer Rasse, Religion, sexuellen Orientierung, Geschlecht oder anderer Merkmale fördern oder unterstützen. Diese Äußerungen können sowohl online als auch offline stattfinden und haben das Potenzial, Schaden anzurichten und die Opfer zu verletzen. Hate Speech wird oft als Verstoß gegen die Meinungsfreiheit betrachtet, aber es gibt rechtliche Grenzen, die den Schutz vor Hass und Diskriminierung gewährleisten sollen. **

Was ist der Unterschied zwischen einem SR- und einem RS-Glied und welche Funktion hat ein SR-Glied anhand seiner Eingänge?
Ein SR-Glied (Set-Reset-Glied) und ein RS-Glied (Reset-Set-Glied) sind zwei verschiedene Arten von Flip-Flops, die in der digitalen Schaltungstechnik verwendet werden. Der Hauptunterschied zwischen ihnen liegt in der Reihenfolge, in der die Eingangssignale angewendet werden, um den Zustand des Flip-Flops zu ändern. Ein SR-Glied hat zwei Eingänge: den Set-Eingang (S) und den Reset-Eingang (R). Je nachdem, welche Eingangssignale anliegen, kann das SR-Glied in einen von vier möglichen Zuständen wechseln: Set (Q=1, Q'=0), Reset (Q=0, Q'=1), Toggle (Q=1, Q'=1) oder Hold (Q=0, Q'=0). Die genaue **
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
Top-Angebote
Produkte zum Begriff Speech Recognition SR:
-
MONACOR Speech-500/gr Das Speech-500 Ist Die Professionelle Lösung -B-Stock-Hinweis: Bei den Artikeln der Kategorie Sales handelt es sich um Restposten oder Artikel aus Kundenretouren. Diese Artikel sind nur in begrenzter Stückzahl vorhanden, voll funktionstüchtig aber teilweise ohne Originalverpackung. Sollten Sie Fragen zu dem hier abgebildeten Produkt haben, kontaktieren Sie uns bitte vor Ihrem Kauf, um mögliche Unstimmigkeiten zu vermeiden. Wir informieren Sie gerne.: Bemerkungen zum Artikel: Gebrauchsspuren vorhanden: Das SPEECH-500 ist die professionelle Lösung: für anspruchsvolle Sprach- und Musikübertragung und ist mit innovativer Technik ausgerüstet. Das Rednerpult kann mittels Elektroantrieb stufenlos in der Höhe eingestellt werden. Ein Notebook kann platzsparend unter der durchsichtigen Pultscheibe in einem speziell dafür vorgesehenen und zweistufig beleuchtbaren Fach untergebracht werden. Keine Wünsche offen lässt das eingebaute Audiosystem sowie die UHF-PLL-Funktechnik mit Sende- und Empfangsmodul. Diese ermöglicht im Audio-Link-Betrieb die kabellose Ansteuerung von weiteren Aktivlautsprechersystemen, die mit entsprechenden Funkempfängern ausgerüstet sind (z. B. TXA-800- und TXA-1000-Serie).Professionelles, elektrisch höhenverstellbares Rednerpult mit integriertem drahtlosem Audiosystem: Eingebauter 4-Kanal-Mischverstärker mit Limiter, 50 W, Elektrische stufenlose Höhenverstellung der Pulthöhe von 85-125 cm, Pult mit durchsichtiger Sicherheitsglasplatte und beleuchtetem Fach für ein Laptop, Eingebauter UHF-PLL-Empfänger (TXA-1822MR) mit 2 x 16 einstellbaren Frequenzen (863,1-864,9 MHz) mit Diversity-System, passende Sender wie TXA-800HSE oder TXA-800HT sind optional erhältlich, Eingebauter UHF-PLL-Sender (TXA-820MT) mit 16 einstellbaren Frequenzen (863,1-864,9 MHz) zum Aufbau von Audio-Funk-Übertragungsstrecken, 3 Eingänge über Kombi-Buchse Mic (XLR)/Line (6,3-mm-Klinke), Stereo-Line-Eingang (Cinch), Gainregler, 3-fach-Klangregelung für die Kombi-Eingänge, 2 schockabsorbierende XLR-Buchsen auf dem Pultaufsatz für 2 optionale Schwanenhalsmikrofone (belegen je einen Mikrofoneingang), passendes Mikrofon EMG-650P optional erhältlich, Zusätzliche XLR-Buchse für LED-Schwanenhalsleuchte (z. B. GNL-453XLR, optional erhältlich), 24-V-Phantomspeisung für Mic-Eingang 1 und 2, 1 Stereo-Line-Ausgang über Cinch-Buchsen, 2-Wege-Lautsprechersystem mit 30-cm-Tieftöner (12") und Hochtonhorn (1"), Hochwertiges Gehäuse in Holz-Lack-Kombination, Standarddekor: Grau, lackiert, Referentenschildhalterung mit Klemmschraube montierbar, 3 zusätzliche Ablagefächer für Dokumente und andere Utensilien, 2 Lenkrollen mit Feststellbremse und 2 starre Rollen, Anmelde- und gebührenfrei in der EU.Lieferung ohne Laptop.Auch in anderen Farben erhältlich:Neben dem Standarddekor „Grau, lackiert” können Sie aus weiteren 20 Design-Optionen Ihre individuelle Farbe oder das passende Wunschdekor auswählen:Ahorn, Apfel dunkel, Buche, Buche dunkel, italienische Eiche, Eiche rötlich, Eiche rustikal, Erle, Kirsche, Kirsche dunkel, Kirsche hell,...3200,00 €*Versand: 99,00 €Sichere Weiterleitung zum Anbieter
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer589,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
MONACOR SPEECH-104DSPEECH-104D, Eine innovative Qualit�tsl�sung f�r die hochwertige Sprach- und Musikbeschallung: Das SPEECH-104D-Aktiv-Rednerpult von MONACOR verbindet Klangqualit�t, Lautst�rkef�higkeit und Komfort in einer perfekten Weise. Akkubetrieben und damit komplett ortsunabh�ngig macht allein das SPEECH-104D aus jeder zu beschallenden Fl�che ein Auditorium. Es passt sich aber selbstverst�ndlich auch in jede gegebene Umgebung ein, wo eine zeitlich begrenzte oder auch permanente Redestelle ben�tigt wird. Die integrierte Verst�rker- und Lautsprechertechnik erlaubt dabei nicht nur die Sprachwiedergabe, sondern macht auch Musik und zum Beispiel Film- und Pr�sentationsvertonungen denkbar gut und einfach. Ein Schwanenhalsmikrofon einstecken und/oder eine Signalquelle anschlie�en - einschalten - fertig.1648,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie nutzt man Windows Speech Recognition richtig in Visual Basic?
Um Windows Speech Recognition in Visual Basic zu nutzen, müssen Sie zunächst sicherstellen, dass Sie die entsprechenden Verweise auf die Speech API in Ihrem Projekt hinzugefügt haben. Dann können Sie die SpeechRecognitionEngine-Klasse verwenden, um Spracheingaben zu erkennen und zu verarbeiten. Sie können Ereignisse wie SpeechRecognized und SpeechRecognitionRejected abonnieren, um auf erkannte oder abgelehnte Spracheingaben zu reagieren. Schließlich können Sie die RecognizeAsync-Methode aufrufen, um die Spracherkennung zu starten und auf Benutzereingaben zu warten. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
-
Wie kann Voice Recognition die Effizienz von Arbeitsabläufen verbessern?
Voice Recognition kann die Effizienz von Arbeitsabläufen verbessern, indem es die Eingabe von Texten beschleunigt und die Notwendigkeit von manueller Dateneingabe reduziert. Durch die Verwendung von Spracherkennung können Mitarbeiter Aufgaben schneller erledigen und sich auf andere wichtige Aufgaben konzentrieren. Dies führt zu einer Steigerung der Produktivität und Effizienz im Arbeitsalltag. **
-
Was kann man tun, wenn das Google Speech Service Update hängt?
Wenn das Google Speech Service Update hängt, gibt es einige Schritte, die du ausprobieren kannst. Zuerst solltest du sicherstellen, dass du über eine stabile Internetverbindung verfügst. Dann kannst du versuchen, das Update manuell neu zu starten oder das Gerät neu zu starten. Wenn das Problem weiterhin besteht, kannst du dich an den Google-Support wenden, um weitere Hilfe zu erhalten. **
Ähnliche Suchbegriffe für Speech Recognition SR
-
Thon Truhencase t.bone Speech 100M Phenol braunThon Truhencase t.bone Speech 100M; Case mit herausnehmbarem 2HE Rack für die Steuereinheit; herausnehmbare Wanne mit 2 Schaumstoffinlays für die Sprechstellen (9 Deligierte oder Präsident) und Mikrofone; Platz für Kabel und Zubehör; Material: 6,5 mm Multiplex; 30 x 30 mm Alukante; 2 Butterflyverschlüsse mittel; 2 Feststellscharniere groß; 4 Klappgriffe mittel; 4 Kugelecken medium; 4 Kugelecken mit L-Ecke medium; 4 Lenkrollen (2 gebremst), Schaumstoffpolsterung; Farbe: Phenol braun; Außenmaße BxTxH: 705 x 595 x 605 mm; Gewicht: 28,7 kg; hergestellt in Deutschland799,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Thon Case t.bone Speech 100M 16xC/D BraunThon Case t.bone Speech 100M 16xC/D; Rollencase passend für t.bone Speech 100M Konferenzsystem; mit herausnehmbaren 2 HE Rack für die Steuereinheit; herausnehmbare Wanne mit 4 Schaumstoffinlays für die Sprechstellen (16 Deligierte oder Präsident) und Mikrofone; Platz für Kabel und Zubehör; Material: 6,8 mm Multiplex phenolharz beschichtet; 30 x 30 mm Alukante; 4 Butterfly-Verschlüsse mittel; 4 Klappgriffe mittel; 4 Kugelecken mittel, 4 Kugelecken mittel mit L-Ecke; 4 Lenkrollen, davon 2 gebremst; Schaumstoffpolsterung; Zubehörfach; Außenmaße BxTxH ca.: 705 x 595 x 782 mm; Gewicht: 33,8 kg; Farbe: braun; Hergestellt in Deutschland; passende Erweiterungsmodule: Art. 508615, Art. 508617 (nicht im Lieferumfang enthalten)875,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was bedeutet Hate Speech?
Hate Speech bezeichnet beleidigende, diskriminierende oder gewalttätige Äußerungen, die aufgrund von Rasse, Religion, Geschlecht, sexueller Orientierung oder anderen persönlichen Merkmalen Hass und Feindseligkeit fördern. Es handelt sich um eine Form der verbalen Gewalt, die Menschen verletzen und ihre Rechte verletzen kann. Hate Speech ist in vielen Ländern gesetzlich verboten und wird von Online-Plattformen und sozialen Medien zunehmend bekämpft. **
-
Was ist Hate Speech?
Hate Speech bezieht sich auf Äußerungen, die Hass, Diskriminierung oder Gewalt gegen bestimmte Personen oder Gruppen aufgrund ihrer Rasse, Religion, sexuellen Orientierung, Geschlecht oder anderer Merkmale fördern oder unterstützen. Diese Äußerungen können sowohl online als auch offline stattfinden und haben das Potenzial, Schaden anzurichten und die Opfer zu verletzen. Hate Speech wird oft als Verstoß gegen die Meinungsfreiheit betrachtet, aber es gibt rechtliche Grenzen, die den Schutz vor Hass und Diskriminierung gewährleisten sollen. **
-
Was ist der Unterschied zwischen einem SR- und einem RS-Glied und welche Funktion hat ein SR-Glied anhand seiner Eingänge?
Ein SR-Glied (Set-Reset-Glied) und ein RS-Glied (Reset-Set-Glied) sind zwei verschiedene Arten von Flip-Flops, die in der digitalen Schaltungstechnik verwendet werden. Der Hauptunterschied zwischen ihnen liegt in der Reihenfolge, in der die Eingangssignale angewendet werden, um den Zustand des Flip-Flops zu ändern. Ein SR-Glied hat zwei Eingänge: den Set-Eingang (S) und den Reset-Eingang (R). Je nachdem, welche Eingangssignale anliegen, kann das SR-Glied in einen von vier möglichen Zuständen wechseln: Set (Q=1, Q'=0), Reset (Q=0, Q'=1), Toggle (Q=1, Q'=1) oder Hold (Q=0, Q'=0). Die genaue **
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.